

Ouvir transcrição
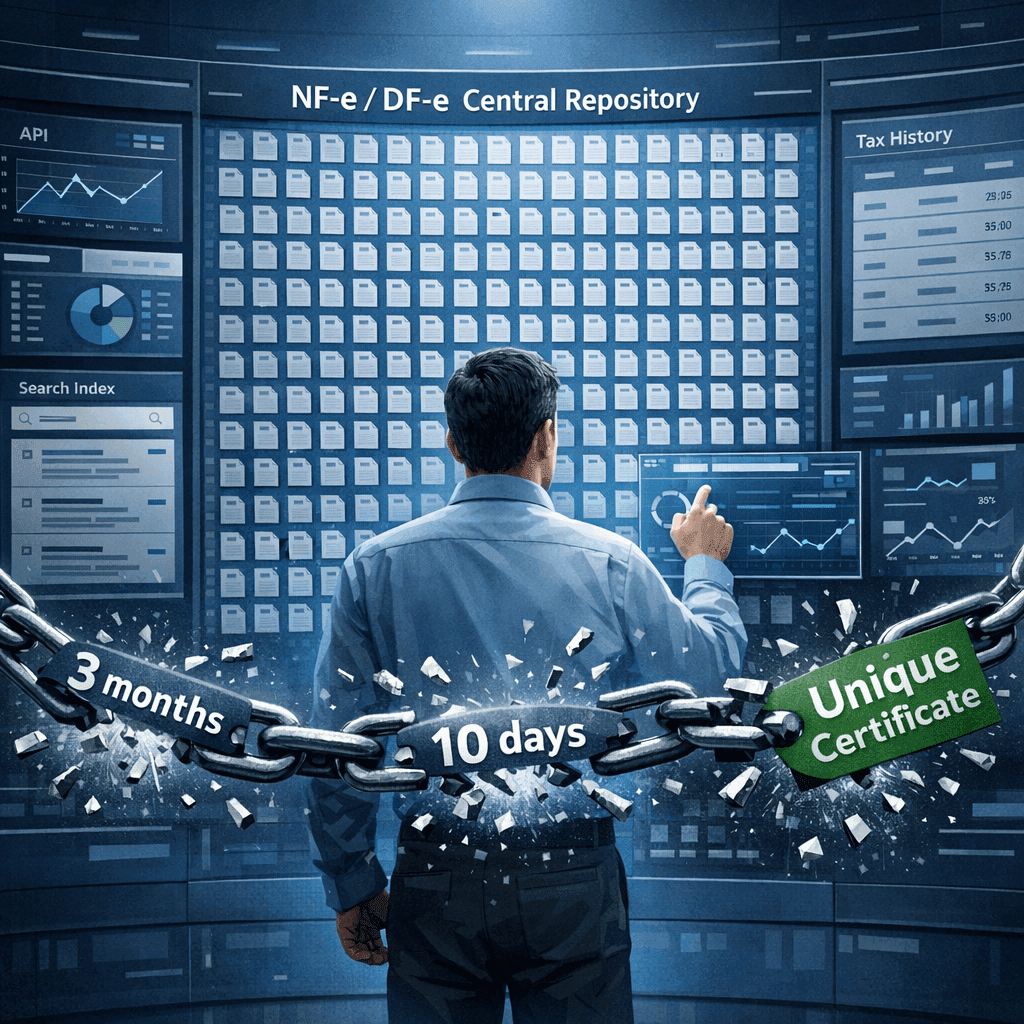
Um repositório fiscal ilimitado resolve o principal gargalo de plataformas fiscais: a dependência operacional da SEFAZ. Ao capturar e armazenar todas as NF-e/DF-e emitidas em uma base própria, seu ERP ou SaaS elimina janelas curtas de consulta, evita bloqueios por ciência fora do prazo, reduz conflitos de certificado e ganha busca histórica instantânea para auditoria, relatórios e replay de eventos.
Pare de construir em cima das limitações da SEFAZ
Imagine acessar qualquer NF-e emitida há anos, baixar sem prazo de 10 dias para ciência e consultar sem o limite de 3 meses da Receita Federal — tudo sem múltiplos certificados brigando pelo mesmo acesso. Para quem constrói plataformas fiscais, middlewares tributários ou ERPs, isso não é luxo: é o pré-requisito para escala.
O problema é que muitos times ainda tratam a SEFAZ como fonte operacional primária, quando ela deveria ser apenas a origem de captura. O resultado aparece no código: jobs frágeis, filas acumuladas, retries infinitos, rate limit informal, falhas de download e clientes reclamando que 'a nota sumiu'. Um repositório central vira a camada de estabilidade entre seu produto e o ambiente fiscal.
As 5 limitações invisíveis da SEFAZ que sabotam pipelines fiscais
| Limitação | Como ela aparece no produto | Impacto técnico | Impacto de negócio |
|---|---|---|---|
| **Janela curta de consulta** | Seu cliente quer uma nota de meses ou anos atrás e a API oficial já não entrega | Dependência de storage externo improvisado ou ausência de histórico | Suporte lento, auditoria incompleta, risco operacional |
| **Prazo para download atrelado à ciência** | XML some do fluxo se o evento não ocorrer em tempo hábil | Jobs precisam disputar prioridade com prazos fiscais | Perda de documento e retrabalho manual |
| **Conflito de múltiplos sistemas por certificado** | ERP, robô fiscal e conciliador acessando com o mesmo cert | Locks, falhas intermitentes e concorrência imprevisível | Instabilidade percebida pelo cliente final |
| **Latência e disponibilidade variáveis** | Consultas funcionam bem em um horário e degradam em outro | Retries, circuit breakers e filas crescentes | SLA ruim e aumento de custo operacional |
| **Busca limitada por chave, período ou evento** | Dificuldade para responder perguntas analíticas | Impossível fazer query rica sem index próprio | Relatórios lentos e produto menos competitivo |
Essas limitações são 'invisíveis' porque normalmente não aparecem no happy path da integração. Elas surgem quando o volume cresce, quando o cliente pede histórico, quando dois serviços consultam simultaneamente ou quando a auditoria exige rastreabilidade de anos. É aí que a arquitetura baseada só em consulta online começa a quebrar.
Blueprint: como desenhar um repositório central de NF-e e DF-e
Checklist de arquitetura mínima
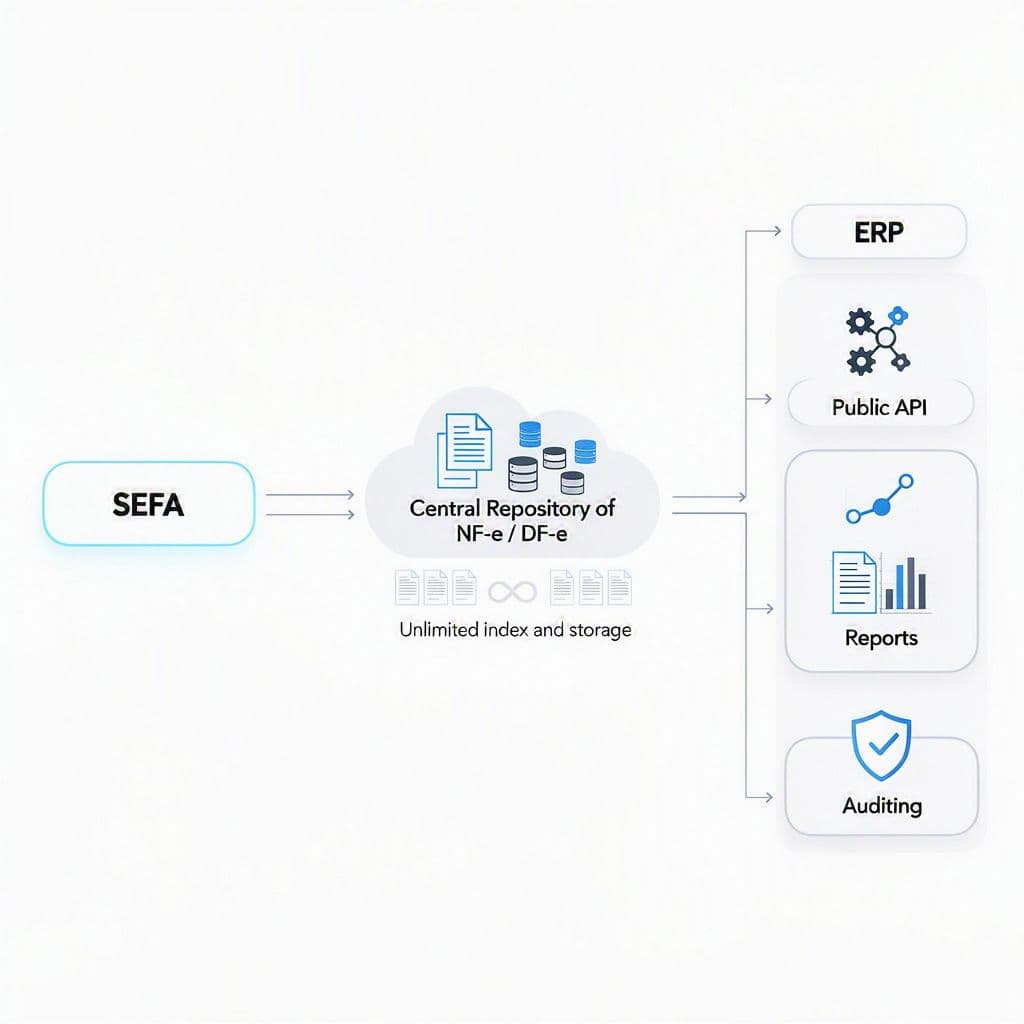
Na prática, o blueprint é simples: envie, indexe e consulte. A SEFAZ entra apenas como origem de aquisição. Depois disso, a verdade operacional passa a ser o seu repositório. Essa inversão reduz acoplamento, melhora previsibilidade e libera o time de engenharia para construir features em vez de remendar integração fiscal.
Aceite lotes de XML e eventos via API, fila ou webhook. Use deduplicação por chave de acesso + tipo de documento + versão do evento para evitar duplicatas e tornar reprocessamentos seguros.
Código prático: endpoints para upload batch, busca full-text e replay histórico
Você não precisa de uma API complexa para começar. Precisa de três contratos sólidos: ingestão em lote, consulta rica e replay. Abaixo está um desenho funcional que serve bem para SaaS fiscais e módulos de ERP.
| Endpoint | Método | Objetivo | Boas práticas |
|---|---|---|---|
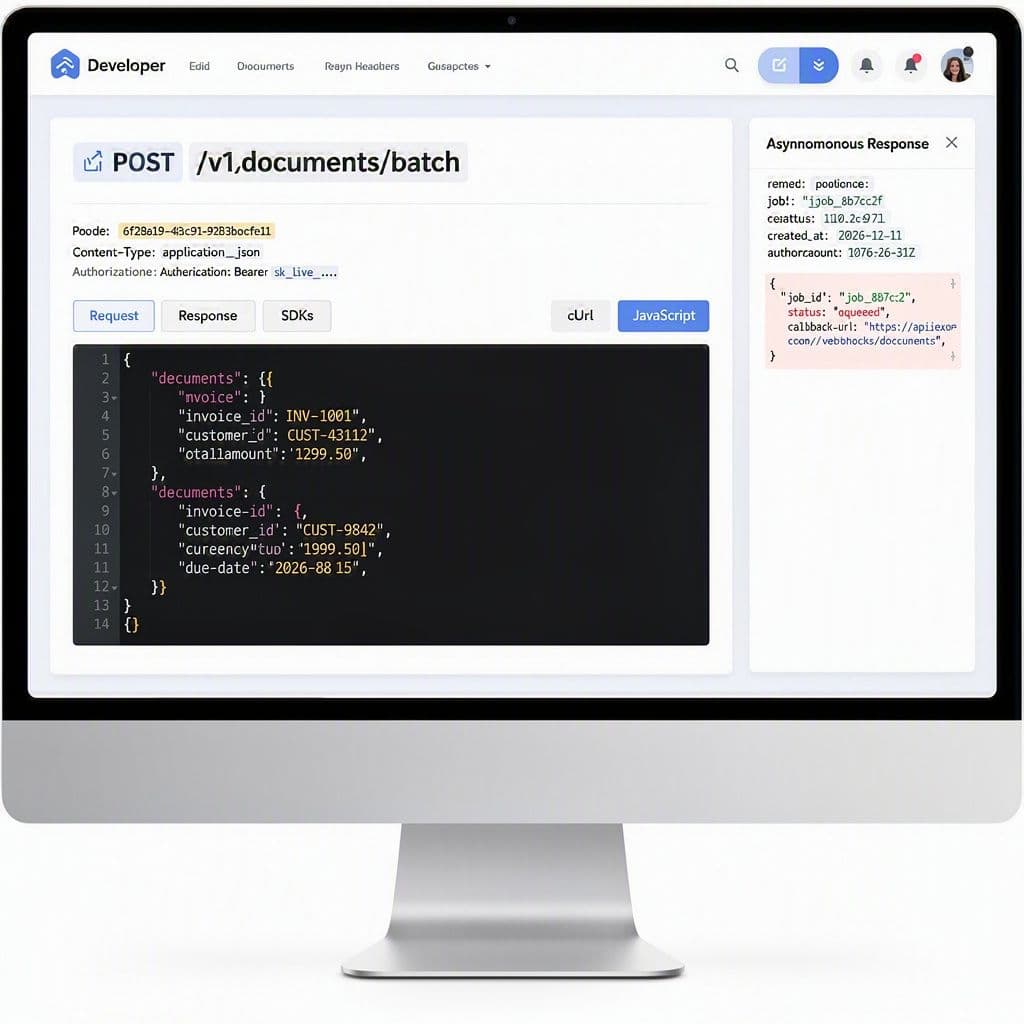
| `/v1/documents/batch` | POST | Receber lotes de NF-e/DF-e e eventos | Idempotency-Key, compressão, processamento assíncrono |
| `/v1/documents/search` | GET ou POST | Buscar por chave, CNPJ, período, CFOP, valor e texto | Paginação por cursor, filtros compostos, ordenação |
| `/v1/documents/{id}/replay` | POST | Reprocessar parser, indexação ou projeções | Fila assíncrona, versionamento, logs de auditoria |
| `/v1/documents/{id}` | GET | Ler XML, metadados e histórico de eventos | ETag, cache, trilha completa |
| `/v1/metrics/coverage` | GET | Ver cobertura do acervo por período e emitente | Indicadores para operação e suporte |
Exemplo de payload para ingestão em lote: um array com XML em base64 ou URL assinada, metadados opcionais e marcação de origem. O ponto crítico não é o formato; é garantir idempotência, observabilidade e separação entre aceite da requisição e processamento pesado.
Se sua aplicação ainda precisa perguntar para a SEFAZ toda vez que o usuário abre uma tela, você não tem um produto escalável — você tem um espelho frágil do ambiente fiscal.
Métricas que justificam a arquitetura: menos chamadas, mais velocidade e menos suporte
Quando o repositório central entra em produção, três ganhos aparecem rápido: queda no volume de chamadas à SEFAZ, redução no tempo de resposta de relatórios e menor dependência de certificados em concorrência. Em operações maduras, cortes de até 90% nas consultas online e ganhos de 10x em relatórios históricos são plenamente plausíveis, porque a leitura passa a ocorrer em base própria indexada.
Comparativo operacional: antes vs. depois do repositório central
Exemplo ilustrativo de uma operação que migrou de consulta direta recorrente para acervo próprio indexado.
Onde times de produto e engenharia erram nessa implementação
Erros comuns ao criar um repositório fiscal
Guardar só o XML bruto já resolve?
Não. XML sem índice vira arquivo morto. O ideal é combinar armazenamento durável com extração de metadados pesquisáveis e histórico de eventos.
Posso manter consulta direta à SEFAZ como fallback permanente?
Sim, mas como fallback, não como caminho principal. Se o fluxo principal continuar acoplado à SEFAZ, você preserva a instabilidade original.
Full-text search faz sentido para documento fiscal?
Faz, principalmente para suporte, auditoria e investigações. Buscar por razão social, produto, observação ou trechos do XML economiza horas de análise manual.
Replay histórico é realmente necessário?
Sim. Sempre que houver mudança de parser, regra de negócio, score de risco ou projeção analítica, o replay permite reconstruir o passado sem parar a operação.
Arquitetura recomendada para escalar sem dor
Uma stack comum e eficiente combina fila + worker de ingestão + object storage + banco indexado + API de leitura + observabilidade. Não precisa ser sofisticada demais no dia 1. O mais importante é ter contratos claros de ingestão, um modelo estável de indexação e uma estratégia explícita de retenção longa.
Simulador rápido de economia de chamadas à SEFAZ
Estime quantas chamadas mensais podem ser evitadas ao migrar consultas recorrentes para um repositório central próprio.
Chamadas potencialmente eliminadas: chamadas/mês 45.000
Como a MagelNet encurta esse caminho
Se você quer o benefício dessa arquitetura sem montar toda a camada do zero, a MagelNet já entrega isso com o Repositório Central de Notas via API. Você envia todas as NF-e/DF-e emitidas para um acervo central e passa a consultar seus documentos sem ficar preso às restrições clássicas da Receita: janela curta de consulta, prazo para download, disputa por certificado e dependência de múltiplos acessos simultâneos.
Na prática, isso significa uma integração mais limpa para o seu produto: menos acoplamento com a SEFAZ, mais previsibilidade para o time de engenharia, buscas históricas sem improviso e uma base pronta para relatórios, auditoria e replay. E o melhor: você pode testar grátis, sem criar conta e sem informar cartão.
Se sua plataforma fiscal ou ERP já sente o peso do volume, este é o momento de trocar remendos por uma base definitiva. Integre o repositório da MagelNet em 15 minutos com nossa API docs e teste grátis em docs.mageln.net/repositorio.
A MagelNet está comprometida em ajudar empresas de todos os tamanhos a tomar decisões informadas. Seguimos diretrizes editoriais rigorosas para garantir que nosso conteúdo atinja e mantenha nossos altos padrões.
O que você achou deste artigo?

Geraldo Magela Fraga
Fundador da MagelNet e do Grupo Magel. Empresário. Advogado. Mestrando em Computação Aplicada. MBA em Business Intelligence.
Comentários (0)
Seja o primeiro a comentar!


