

Ouvir transcrição
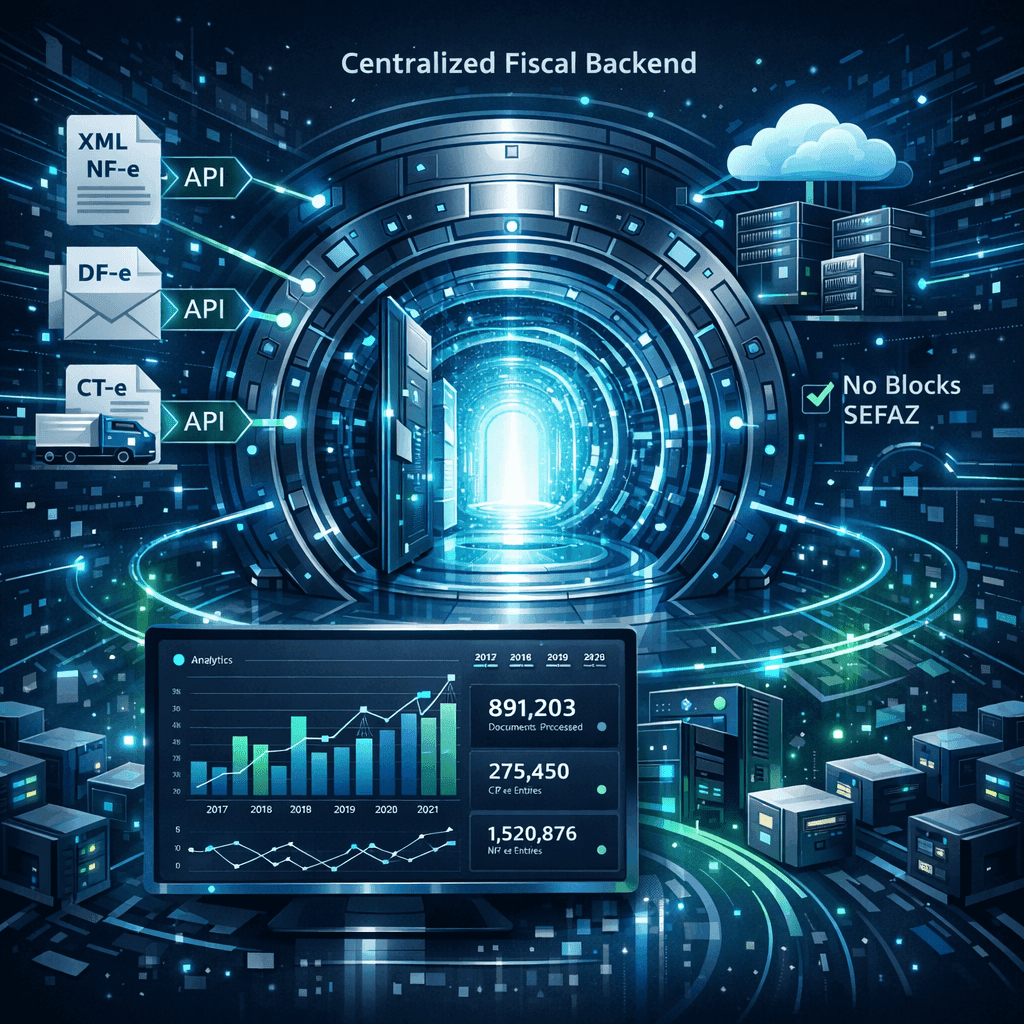
Um repositório fiscal infinito resolve o maior gargalo de ERPs e plataformas fiscais: ele guarda XMLs de NF-e, DF-e e CT-e fora das restrições operacionais da Sefaz, permitindo consulta histórica de qualquer época, upload em lote por API e acesso por múltiplos sistemas sem travar certificado. Na prática, você troca uma dependência instável por uma camada própria, pesquisável e escalável.
O problema real: depender da Sefaz como se ela fosse seu banco de dados
Você já perdeu uma NF-e de 2 anos atrás porque a Sefaz só devolve uma janela curta de consulta? Ou travou o download porque ninguém deu ciência da operação em 10 dias? Para quem desenvolve backend fiscal, isso não é detalhe: é uma limitação estrutural. A Sefaz foi feita para autorização e distribuição regulada, não para funcionar como repositório histórico eterno do seu produto.
Quando o seu app consulta documentos fiscais direto na origem, ele herda cada regra de retenção, cada timeout, cada bloqueio por certificado e cada oscilação de disponibilidade. O resultado é previsível: suporte sobrecarregado, clientes culpando o ERP e times de engenharia criando contornos para um problema que deveria ser resolvido na arquitetura.
As 5 limitações da Receita que mais quebram produtos fiscais
| Limitação | Como acontece na prática | Impacto no ERP/plataforma |
|---|---|---|
| **Janela curta de consulta** | Muitas rotinas operam com recuperação de apenas **últimos 90 dias** ou períodos restritos por serviço. | Seu cliente pede um XML antigo e o sistema não consegue responder. |
| **Ciência obrigatória para download completo** | Sem manifestação dentro do prazo, o XML completo pode deixar de ficar disponível para certas rotinas. | Downgrade de experiência, falha de auditoria e retrabalho operacional. |
| **Prazo operacional apertado** | Regras como a de **10 dias** para determinados fluxos exigem monitoramento constante. | Se ninguém agir no prazo, o documento pode ficar inacessível pelo canal esperado. |
| **Certificado digital concorrente** | Mais de um sistema consultando com o mesmo certificado costuma gerar conflito, bloqueio ou instabilidade. | Integrações paralelas brigam entre si e a operação fica frágil. |
| **Dependência de disponibilidade externa** | Consulta, distribuição e download dependem da fila, latência e saúde do ambiente externo. | Sua SLA fica atrelada a um serviço que você não controla. |
Para o usuário final, tudo isso parece um único bug: “meu ERP não achou a nota”. Para o time técnico, são cinco fontes diferentes de atrito. E todas apontam para a mesma conclusão: se o XML passou pelo seu fluxo, ele precisa ser armazenado em um repositório próprio e consultável por API.
Arquitetura recomendada: um cofre fiscal centralizado entre captura e consumo
Checklist de arquitetura mínima para não depender da Sefaz no histórico
Fluxo simples de upload via API: batch de XMLs chaveados
O fluxo mais robusto é simples: seu backend recebe ou gera os XMLs, monta um lote e envia para um endpoint central. Depois disso, toda consulta histórica passa a sair do seu repositório fiscal, não da Sefaz. Isso reduz acoplamento, melhora observabilidade e transforma suporte em busca indexada — não em caça ao documento perdido.
Exemplo de payload de upload em lote
Um formato comum é enviar um array com documentos chaveados e metadados mínimos de indexação. Exemplo ilustrativo:
POST /api/repository/documents/batch\n{\n "documents": [\n {\n "accessKey": "35240612345678000123550010000012341000012345",\n "documentType": "NFE",\n "issuerCnpj": "12345678000123",\n "recipientCnpj": "99887766000155",\n "issueDate": "2024-06-18T10:20:00Z",\n "xmlBase64": "PD94bWwgdmVyc2lvbj0iMS4wIiBlbmNvZGlu..."\n }\n ]\n}
Consultas ilimitadas: qualquer época, mesmo com múltiplos sistemas e certificados
Depois que o XML está no repositório, consultar uma nota de ontem ou de 3 anos atrás vira exatamente o mesmo problema técnico: uma busca indexada. Esse é o ponto em que sua plataforma deixa de ser refém das janelas operacionais da Receita e passa a oferecer uma experiência previsível para cliente, suporte, auditoria e integrações internas.
| Cenário | Sem repositório central | Com repositório fiscal via API |
|---|---|---|
| Cliente pede XML de 24 meses atrás | Alta chance de indisponibilidade ou ausência de retorno | Busca direta por chave ou filtro de período |
| Dois sistemas usando o mesmo certificado | Conflito operacional e risco de bloqueio | Consulta histórica desacoplada do certificado original |
| Backfill de legado | Importação lenta e inconsistente | Carga em lote com pipeline controlado |
| Auditoria ou fiscalização | Busca manual, retrabalho e lacunas | Histórico consolidado e rastreável |
| Escala de documentos | Dependência de serviços externos por consulta | Leitura em infraestrutura própria, cacheável e observável |
Exemplo de integração em Node.js
Exemplo didático de envio em lote e consulta posterior:
const axios = require('axios');\n\nasync function uploadBatch(documents) {\n const { data } = await axios.post('https://api.magelnet.com/repository/documents/batch', { documents }, {\n headers: { Authorization: 'Bearer SEU_TOKEN' }\n });\n return data;\n}\n\nasync function findByAccessKey(accessKey) {\n const { data } = await axios.get(`https://api.magelnet.com/repository/documents/${accessKey}`, {\n headers: { Authorization: 'Bearer SEU_TOKEN' }\n });\n return data;\n}
Exemplo de integração em Python
import requests\n\nBASE_URL = 'https://api.magelnet.com'\nHEADERS = {'Authorization': 'Bearer SEU_TOKEN'}\n\ndef upload_batch(documents):\n response = requests.post(\n f'{BASE_URL}/repository/documents/batch',\n json={'documents': documents},\n headers=HEADERS,\n timeout=30\n )\n response.raise_for_status()\n return response.json()\n\ndef find_by_access_key(access_key):\n response = requests.get(\n f'{BASE_URL}/repository/documents/{access_key}',\n headers=HEADERS,\n timeout=15\n )\n response.raise_for_status()\n return response.json()
Escalabilidade na prática: o que muda quando você passa de milhares para 1M+ notas
Em baixa escala, consultar XML manualmente ainda parece aceitável. Em alta escala, vira um passivo. Quando sua base cresce para centenas de milhares ou milhões de documentos, entram em cena problemas de throughput, retentativa, deduplicação, indexação, cold storage, custo de leitura e observabilidade. É aqui que um repositório fiscal bem desenhado deixa de ser “nice to have” e vira infraestrutura crítica.
Comparativo de maturidade operacional por volume documental
Valores ilustrativos para mostrar como a dependência direta da origem piora com o aumento do volume.
Casos reais de arquitetura madura costumam seguir o mesmo padrão: ingestão assíncrona, filas para retentativa, indexação por chave e participante, deduplicação por hash/chave, trilha de auditoria e leitura otimizada para suporte e integrações. O objetivo não é só guardar XML; é garantir que 1M+ notas continuem acessíveis sem downtime perceptível para o usuário final.
Calculadora rápida: quanto retrabalho seu time evita ao centralizar o histórico?
Estimativa de horas poupadas por mês
Simule o retrabalho mensal causado por buscas manuais, falhas de consulta e pedidos de XML antigo.
Horas poupadas por mês: horas 11,2
FAQ técnico para times de backend fiscal
Perguntas frequentes
Um repositório central substitui totalmente a consulta na Sefaz?
Ele não substitui a função regulatória da Sefaz, mas reduz drasticamente a dependência dela para histórico, suporte, auditoria e integrações. A captura continua existindo; a consulta histórica passa a ser sua.
Posso enviar documentos antigos em backfill?
Sim. Esse é um dos maiores ganhos. Você pode importar legado em lote e unificar anos de XMLs num único índice pesquisável.
Como lidar com múltiplos certificados?
A melhor prática é usar certificado apenas onde ele é realmente exigido na captura ou autorização. Depois da ingestão, a leitura do histórico não precisa continuar acoplada ao mesmo certificado.
Isso serve só para NF-e?
Não. A lógica se aplica a NF-e, DF-e, CT-e e outros documentos eletrônicos, desde que o repositório trate tipos documentais, metadados e eventos de forma consistente.
O ponto estratégico: sua plataforma precisa de memória própria
Se o seu produto fiscal ainda trata a Sefaz como camada primária de histórico, você está construindo em cima de uma limitação previsível. A solução mais segura é criar uma arquitetura em que cada XML relevante vá para um cofre fiscal centralizado, com busca rápida, retenção longa e acesso consistente via API. Isso reduz frustração do cliente, simplifica suporte e melhora a confiabilidade percebida do seu software.
É exatamente aqui que a API da MagelNet entra: ela transforma seu app em um repositório central de NF-e, DF-e e CT-e, eliminando a dependência da Sefaz para consulta histórica e removendo gargalos como janela curta de busca, ciência obrigatória para certos fluxos e conflito de certificado entre sistemas. Em vez de improvisar workarounds, você pluga uma camada pronta para ingestão, indexação e consulta.
Copie o código pronto nos docs da MagelNet e teste grátis seu primeiro upload em 2 minutos. Sem criar conta, sem cartão e sem burocracia: é a forma mais rápida de validar no seu backend um histórico fiscal eterno, pesquisável e escalável.
A MagelNet está comprometida em ajudar empresas de todos os tamanhos a tomar decisões informadas. Seguimos diretrizes editoriais rigorosas para garantir que nosso conteúdo atinja e mantenha nossos altos padrões.
O que você achou deste artigo?

Geraldo Magela Fraga
Fundador da MagelNet e do Grupo Magel. Empresário. Advogado. Mestrando em Computação Aplicada. MBA em Business Intelligence.
Comentários (0)
Seja o primeiro a comentar!


